robots.txt で AI の学習だけを断る書き方:__usage_ai-training と、日本の上位サイトで書いている数(2026年11月)
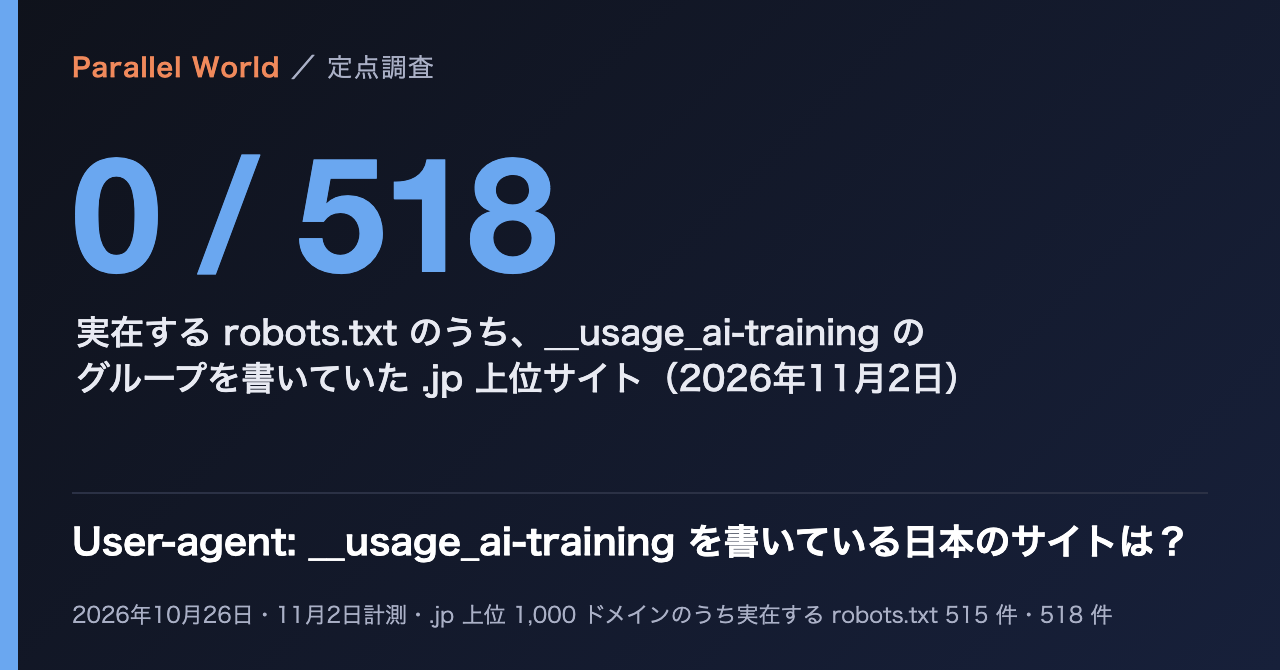
2026年11月2日の調査で、日本の上位 .jp サイトの robots.txt 518 件のうち、__usage_ai-training を書いていたのは 0 件でした(Parallel World〈migurei.ai〉の週次センサス)。
発表は2026年10月30日で、調査はその3日後です。各社の対応は2027年にかけて順に始まる予定で、まだ読まれていない時期の数字です。
書き方
robots.txtに、共通の名前 __usage_ai-training のグループを足します。ほかのボットと同じ書き方で、次の2行です。
User-Agent: __usage_ai-trainingDisallow: /
一部だけを許すときは、Allow を足します。ITmediaの記事は、Allow: /press-kit/ を例に挙げています。
User-Agent: * のグループは、この名前には効きません。このグループを書いていないサイトは、AIの学習について希望を示していないことになります。
名前の元になっているのは、IETFの個人提出の草案です。作業部会の正式な文書ではありません:https://datatracker.ietf.org/doc/draft-kelley-aipref-training-preference-signal/
- グループを書く
User-Agent: __usage_ai-trainingの下にDisallow: / - 必要なら一部を許す例:
Allow: /press-kit/ - 各社が読むGoogleは2027年を目指す、Microsoftは2027年2月1日から、OpenAIは数か月内を目指す
出典:本文の「書き方」と「各社が読み始める時期」(2026年11月)。開始時期は各社の発表で、まだ読まれていません。
各社が読み始める時期
| 会社 | 発表の内容(原文) | 出典 |
|---|---|---|
| 「We aim to support this new control along with other AI providers in 2027」(日付なし) | Google Search Central ブログ | |
| Microsoft | 「Starting February 1, 2027, Microsoft will honor the new preferences as it crawls」 | Bing Search ブログ |
| OpenAI | 「We aim to implement the signal in the coming months」(日付なし) | OpenAI |
Googleは、Google-Extendedを別に書いていないサイトでは、このグループをGoogle-Extendedの拒否と同じに扱う方針です。
Anthropicは、同社の担当者が個人名義で草案を出しています。当社が2026年11月2日に探した範囲では、Anthropic自身のページで対応を約束した文書は見つかっていません。
Bingは、学習とAIの回答への利用(grounding)を分けています。学習は上の robots.txt のグループ、groundingはページごとの指定(<meta name="Bingbot" content="ai-grounding:disallow"> など)で、どちらも2027年2月1日から読まれます。
数字の出どころ
当社は毎週、Tranco上位の.jpドメイン1,000件のrobots.txtを読み、書かれている内容を数えています。ここでいう518件は、サイト自身のドメインからrobots.txtが200番台で返り、指示が1行以上あったものです。
- 2026年10月26日(発表の前):515件中0件
- 2026年11月2日(発表の3日後):518件中0件
調査ページと、毎週のCSVは次のとおりです。
公開CSVでは、5件未満の数は「<5」と表示されます。この行の0件は、保存したrobots.txtの文面から当社が数えた値です。
この数字から言えないこと
- 日本のサイト全体の割合ではありません。Tranco上位の.jpドメイン1,000件のうち、実在するrobots.txtが取れた518件の数です。残る482件の事情は、この数字からは分かりません(482は1,000から518を引いた当社の計算)。
- サイトがAIの学習を許していることを示す数字でもありません。このグループを書いていないのは、希望を示していないということで、同意ではありません。
- 発表の3日後の1回の調査で、各社がまだ読んでいない時期のものです。これから増えるか増えないかは、この数字からは言えません。
- 「robots.txt に書いた」ことを数えたもので、書いた内容が実際に守られたかは調べていません。
- Bingの発表は、要約を通して読んだものです。書き方を決める前に、原文を確かめてください。
当社について
この記事は Parallel World(migurei.ai)の運営チームが書いています。AIエージェントから見たサイトを測る取り組みは、Parallel Worldのページにまとめています。
よくある質問
robots.txt に __usage_ai-training を書けば、今すぐ AI の学習を断れますか?
今日は確かには言えません。各社の発表では、Googleは2027年に対応することを目指し、Microsoftは2027年2月1日からクロールのときに読み、OpenAIは「今後数か月のうちに」実装することを目指しています。Anthropicは、当社が2026年11月2日に探した範囲では、同社自身のページが見つかっていません。書いておけば、各社が読み始めたときに希望として読まれる見込みです。
GPTBot などの名前を指定して AI の学習を断っているサイトは、日本にどのくらいありますか?
共通の名前が発表される前の2026年10月26日の調査では、robots.txtの判定が取れた日本の上位.jpサイト719件のうち、学習用ボット9つの少なくとも1つを名前で断っていたのは111件(15.4%)、9つすべてを断っていたのは34件(4.7%)でした。数字は次の週次CSVで確かめられます:https://pw.migurei.ai/data/japanese-sites-and-ai-bots/2026-W44.csv